그리고 이 벡터들을 비교하면, 두 벡터의 거리(distance) 가 가깝다 → 의미가 비슷하다 멀다 → 의미가 다르다 의미 기반 검색, RAG, 추천 시스템 등이 가능하다.
마무리로는 벡터 DB 에 저장을 한다.
현회사 플로우
파일 업로드 (프론트엔드 / 업로드 서버)
사용자가 파일(예: PDF, CSV, 이미지 등)을 업로드
서버에서 파일을스토리지(S3, GCS, NAS 등)에 저장
업로드 완료 후,파일 메타데이터 (파일명, 경로, 상태 등)를 DB에 기록
ETL 중 Extract(추출)단계의 준비 과정 -> 데이터가 들어오는 지점을 만드는 단계
인덱싱 처리 (Python 서비스)
Python이 업로드된 파일을 감시(watch)하거나, 업로드 완료 이벤트를 받아서 실행
파일 내용을 읽고(예: 텍스트 추출, OCR, 파싱 등)
내용 기반으로인덱스 생성(예: Elasticsearch, OpenSearch, Vector DB 등)
인덱스 정보를 검색 서버나 DB에 저장
Transform + Load단계에 해당 -> 데이터를가공하고 저장소에 적재하는 과정
순서 요약
사용자가 파일 업로드 (Extract)
Python 인덱싱 서버가 파일을 읽고 텍스트 추출 (Transform 시작)
Chunking으로 문서를 의미 단위로 나눔
각 Chunk를 Embedding 모델로 숫자 벡터로 변환
이 벡터를 벡터 DB (예: Pinecone, FAISS, Qdrant, Elasticsearch Vector) 에 저장 (Load)
사용처
모델
주요 사용처
LLM
광범위하고 복잡한 작업: 일반 목적의 챗봇, 창의적인 콘텐츠 생성 (소설, 시), 복잡한 코드 생성/디버깅, 다국어 번역, 고급 추론 및 분석.
SLLM
특정 도메인 및 경량 작업: 온디바이스 비서 (e.g., 스마트폰), 특정 분야 고객 지원 챗봇, 실시간 음성 인식/요약, 내부 문서 검색(RAG와 결합), 간단한 텍스트 분류/요약.
LLM/SLLM의 주요 기법
기법
설명
주요 활용 목적
프롬프트 엔지니어링 (Prompt Engineering)
모델에 최적의 질문/지시를 설계하여 원하는 결과 유도 (Fine-tuning보다 쉽고 빠름).
기본 모델의 성능 향상, 특정 형식 출력 유도.
검색 증강 생성 (RAG: Retrieval-Augmented Generation)
외부 지식 기반(DB, 문서)에서 관련 정보를 검색하고, 이를 프롬프트에 넣어 모델이 정확한 답변을 생성하도록 지원.
환각(Hallucination) 감소, 최신 정보/도메인 특화 지식 활용.
CoT (Chain-of-Thought)
모델이 최종 답변 전에 단계별 추론 과정(사고 과정)을 생성하도록 유도하는 프롬프트 기법.
복잡한 추론 문제 (수학, 논리) 해결 능력 향상.
지식 증류 (Knowledge Distillation)
대형 모델(Teacher)의 지식을 경량 모델(Student)에게 전이시켜, 소형 모델이 대형 모델에 가까운 성능을 내도록 학습시키는 기법.
SLLM 제작 및 모델 경량화.
양자화 (Quantization)
모델의 가중치(Weights)를 32bit에서 8bit, 4bit 등 더 낮은 정밀도로 변환하여 모델 크기와 메모리 사용량을 줄이는 기법.
SLLM 배포 시 추론 속도 및 효율 극대화 (CPU, 엣지 장치).
프론트엔드 개발자가 알아야 할 중요한 포인트!! 이게 핵심!!
적을 알아야 이길 수 있다. ! 항상 하는일만 하는 프론트엔드 개발자가 아니라 뒷단이 어떤식으로 돌아가고 어떤 제약이 있는지 미리 파악을 해서 문제해결을 해나가야한다고 생각한다. 가장 중요한 부분은
프론트엔드 개발자가 LLM/SLLM 기반 서비스를 구축할 때 고려해야 할 핵심 사항은 성능, 비용, 사용자 경험(UX)이다.
기존 HTTP 로 응답값을 받으면 한 번의 받는 방식이라 실시간 스트리밍으로 이벤트 기반으로 받는 방법을 사용한다 이 이유는
응답 지연 (Latency) 및 스트리밍 처리를 위해서 이고 API 호출 제한을 둬서 LLM 서비스는 호출당 비용이 발생하므로 프론트엔드에서 무분별한 API 호출을 방지하고 요청 수 제한(Rate Limiting)을 두는 것이 중요하다.
SLLM의 온디바이스 배포
경량 모델 활용: SLLM을 사용하는 경우 WebAssembly (Wasm) 또는 WebGPU와 같은 기술을 활용하여 모델의 추론을 사용자 브라우저에서 직접 실행할 수 있다. WebGPU 는 2023년에 나온 브라우저에서 gpu 를 사용해서 그래픽 연산이 가능하다고 한다. 해당 부분을 활용하면.. 공공기관 같은 폐쇄형 프로젝트에 엄청난 속도 개선이 가능하지 않을까ㅣ? 라고 생각한다. 여러가지 가능성을 염두에 두고 고민을 해봐야하는 부분 같아 보인다.
프론트엔드 개발자의 RAG 최적화 포인트
전처리 단계 최적화를 진행 한다. RAG 파이프라인의 핵심인 청크 생성은 백엔드에서 이루어지지만, 프론트엔드에서 업로드되는 파일의 품질을 관리함으로써 백엔드 청크 처리의 효율을 높일 수 있다.
(대용량 파일 제한, 필요 없는 정보 제거 안내) 따로 좀 더 생각 하면서 고민 한 부분이지만
텍스트 추출 및 검토 UI 제공하여 청크의 품질을 높이는 건 어떤가 좀 고민을 해봤다 아래와 같은내용으로 진행을 한다면
좀 더 빠르고 정확한 품질 좋은 답변이 오지 않을까 생각해봤다.
사용자가 업로드한 PDF/DOCX 파일에서 텍스트만 미리 추출하여 프론트엔드에 보여주고, 사용자가 직접 RAG에 포함할 필요가 없는 텍스트(예: 목차, 법적 고지 등)를 제거할 수 있는 전처리 UI를 제공할 수 있습니다. 이를 통해 백엔드는 이미 정제된 텍스트만 받게 된다. 위화 같이 한다면 가장 골치덩어리였던... sllm 의 정확하지 못한 부분의 답변을 좀 더 품질을 높일 수 있지 않을까 생각했다.
위와 같이 sllm 과 llm 어떤식으로 바라보면 프론트가 정말 할일이 없어 보이지만 사실상 프론트에서도 많은 일을 개선시킬 수 있는 중요한 역할을 한다고 생각을 한다.
RAG (파인튜닝)을 사용하여 커스텀 마이징된 부분으로 솔루션 개발을 해야하는 부분이었다.( 문서 생성 _ 템플릿 형태에 맞게 llm 이 만들어주는 부분)
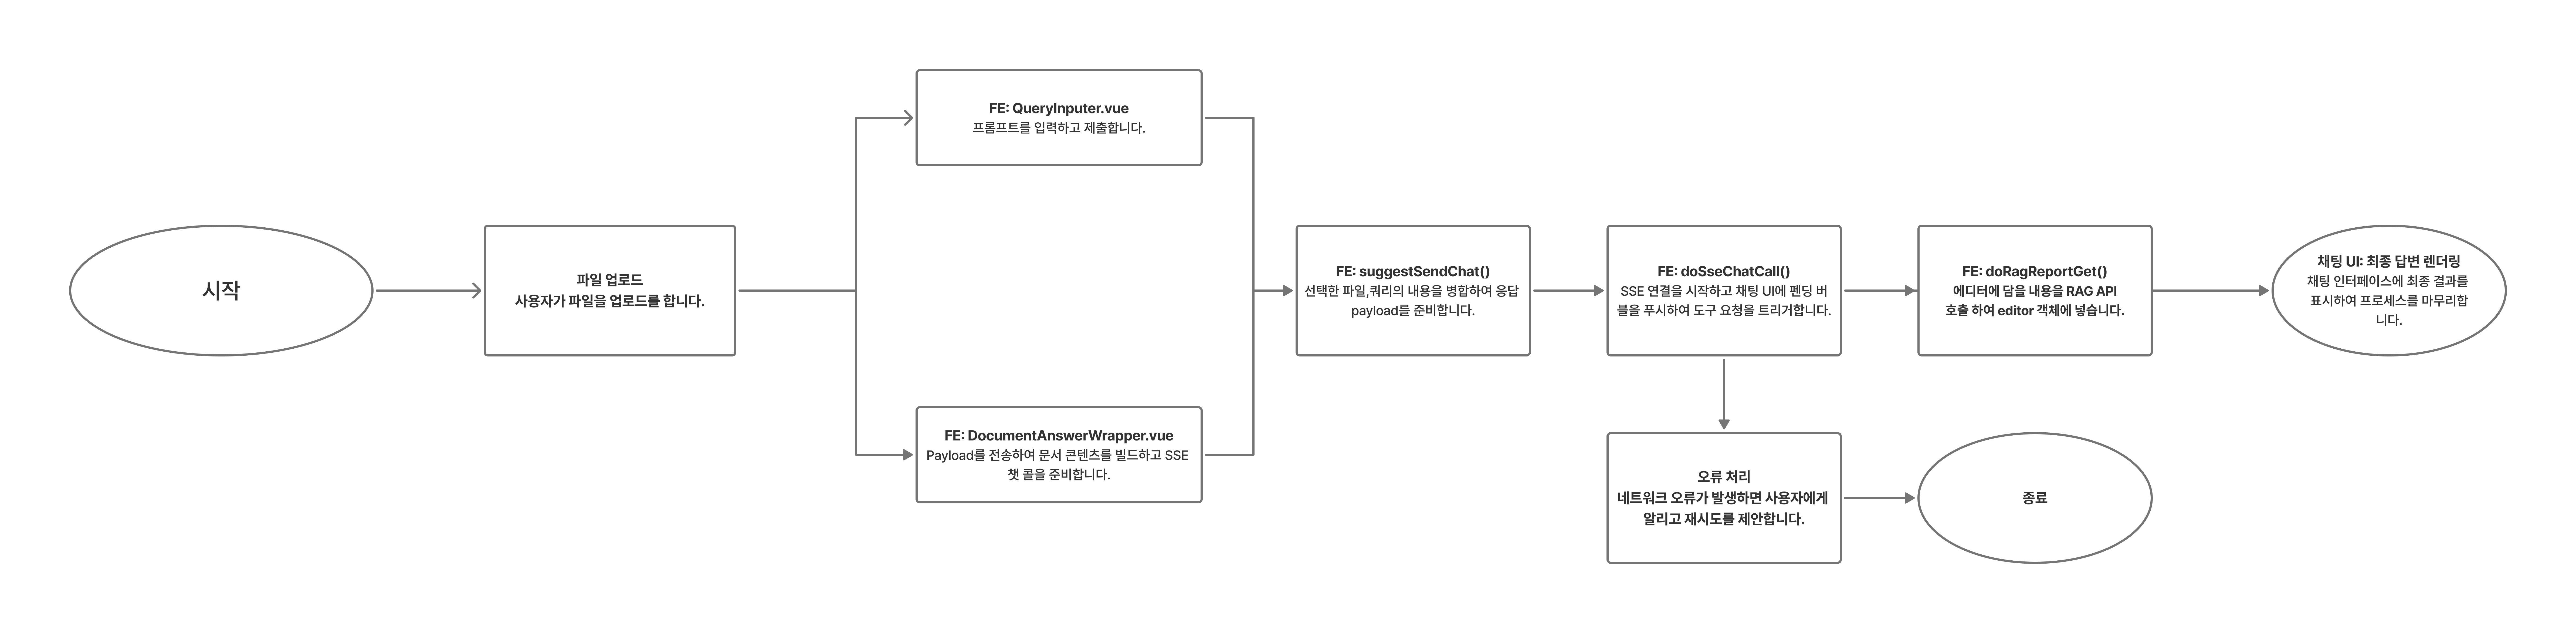
내가 한 일은 프론트에서 백엔드 측으로 안정화 된 컨텐트를 넘기거나 파일 아이디 및 질의어를 던져
백엔드가 청크를 절약하여 상품의 품질을 끌어올리는 작업을 진행했다.
백엔드 파이프라인 설명을 간단히 하면
업로드 -> 파일매니저 저장 -> 인덱싱 서버가 가져가서 파싱 임베딩 업서트 RAG 에서 리트리브 + 리랭크 ( 파이썬) -> llm 답변-> 프론트 표시 ( 파일은 올릴 수 있거나 아닐 수 있다.)
위에 과정을 걸치면서 속도가 굉장히 느리거나 답변에 품질이 떨어지는 경우가 있어서 프론트도 전처리 과정에서 도움이 될만한 부분을 찾아서 진행을 했다. 파일을 올리는 과정에서도 추가적으로 제안을 해 MD 파일로 올리는게 어떻냐고 백엔드측에 협업을 요청하여
마크다운 형태가 좀 더 llm 이 제대로 알아 볼 수 있는 부분같아서 파일을 서버의 업로드 후 md 파일에 내용을 받을 수 있도록 한 후 사용자가 저장을 클릭하거나 업로드 시 md 파일로 전환하여 서버에 저장을 시킨 후 RAG API 를 호출하였다.
md 파일을 제대로 알아보는 부분이 크다고 파이썬 백엔드쪽 답변이 왔을 때 ㅎㅎ 제대로 자료를 찾아본 것 같아서 기분이 좋았다.
가장 예를 먹은 부분은 아래와 같은 비즈니스 로직을 수정하는 부분이었다.
프런트(에디터)에서 수정→다시 보내기 플로우
해당 부분은 전에 대화를 멀티턴 작업을 하기전에 다시 보내서 RAG가 작업을 좀 더 잘 할 수 있게 보안이 되고자
다시 경량적으로 전처리를 해서 보내는게 필요한 작업이었다.
에디터 내용을 사용자가 수정 후
경량 전처리(프런트)
규칙 기반 필터링(정규식/불용어/중복)
코드·표·로그 head/tail 축약 (중간 ...omitted로 명시)
마크다운/유니코드 sanitize (펜스/개행/제로위드 문자 보정)
문단으로 청크 분할 + mini TF/IDF 프리필터(리랭크 없이 상위 N만 추림) 프론트에서는 리랭크를 할 수 없기에 다른 방법으로 경량시킴
처리를 진행 하였고 구글링 및 AI 도움을 받아 최대한 프론트에서 작은 전처리를 진행하도록 했다.
위 작업을 진행 후 RAG 를 호출 하여 헤더/요약 우선 + 선별한 문단만 백엔드에 전달 하여 토큰/ 지연/ 비용 절감을 할 수 있었다.
응답이 올경우 간혹가다가 llm 이 좋은 모델을 쓰는게 아니라면 마크다운 규칙위반과 포맷이 깨짐이 생기면 후처리를 진행하였다.
축약하면 안 되는 경우
핵심 정보가 들어있는 본문은 최대한 보존 시키고
숫자 표 로그 등은 최대한 중간 줄 생략을 하지 않게 만들고
축약해도 되는 경우
중복문장, 불필요한 인사말/ 푸터 -> 의미 없는 부분등 백엔드와 규칙을 세워서 없애거나
이미 업로드 되어있는 부분과 비교하여 이미 샘플을 백엔드가 가지고 있을 경우 생략 됨으로 표시를 넣어서 백엔드에게 알려줌
형식만 있는 구간 긴 구분선, 공백라인 ㅡ 템플릿 문구등은 제거 함
프론트에서 일단 가볍게 재정리를 진행 한다 중복제거 와 노이즈제거 그리고 긴 문장을 다시 보내지 않고 사용자가 수정한 부분은 체크해서 다시 넣은 후 백엔드에게 관련 있는 문단만 우선 추려서 넘긴 후 백엔드 리랭커가 최종적으로 중요한 청크를 고르게 정확도를 확보 할 수 있도록 지원을 해준다. 프론트에서는 너무 과도한 축약을 하지 않고 토큰 절약 + 맥락 보존 균형을 유지하게 해서 협업을 진행하여
RAG 쪽에서 품질을 높일 수 있도록 도구 역할을 추가해주는 느낌으로 작업을 해서 품질에 대한 부분을 높이려고 노력했다.
해당 부분으로 백단에서도 많은 작업을 해주지만 프론트에서 미리 알 수 있는 정보 예: 사용자가 수정을 한 부분
등을 llm 모델이 성능이 많이 떨어지는 모델이어서 도움을 줄 수 있도록 작업을 처리해서 완료했다.
오늘 주제는 chat Ai 파인튜닝하는 중견회사로 이직해서 프론트개발자로서 작업 한 내용을 올려보고자 한다.
이번 프로젝트는 중견기업의 Chat AI 작업이었는데, 내가 맡은 부분은 프론트엔드. AI 모델 성능은 백엔드/데이터팀에서 다루고 있었고, 나는 이걸 어떻게 사용자 입장에서 편하고 자연스럽게 쓸 수 있게 만들까? 에 집중했다.
일단 실시간 스트리밍 작업이 꽤 많았고 파일 업로드 진행 하는 부분들도 꽤나 많고 단순해보였지만 정말 많은 기능들이 들어가 있었다.
처음 접해보는 도메인 지식에 꽤나 당황했고 낮설게 다가왔다.
사용자 페이지와 관리자 페이지가 따로 분리되어 있었으며 시나리오 마다 가지고 있는 옵션 값들도 차이가 있었고
그 내용은 서로 얽혀있었고.. 정말 많은 정보들이 있어서 꽤 파악하는데 진을 정말 많이 뺐다.
문제점
초기 프론트 구조는 SI 스타일 그대로라서 이런 문제들이 있었디.
AI 응답이 한 번에만 떨어져서 긴 답변 대기 시간이 너무 김
로딩 UI는 그냥 스피너만 돌아가서 UX 별로
Vue2 Options API 기반이라 코드 구조 뒤엉킴 → API, UI, 로직이 한데 섞임
팀원 간 API는 어디 넣냐 같은 불필요한 논쟁이 생기고
es6, es7 최신 문법을 쓰지 않아서 몇천줄이 넘는 코드 로직..(명령형으로 태스크 고려하지 않고 짠 코드...) 비동기 동기를 제대로 파악하지 않고 쓴 코드..
프론트에서 너무 많은 잔버그로 인해서 퀄리티가 낮아지는 문제점
큰 플로우가 정리 되어있지 않고 흩어져있어서 어떤식으로 나아가야할지 문제가 있었다.
그리고... 응답이 느릴 경우 태스크를 신경 쓰지 않고 마구 잡이로 진행한 덕에
느려진 UI 정말 힘들었다..어디서부터 어떻게 끌고 갈지 고민하고 고민한 끝에
UI/UX 기획적으로 플어나 갈 수 있는 방안을 먼저 고려해서 작업을 실행 하기로 했다.
코드의 답이 있겠냐만 최소한의 규칙과 낮은 결합도와 높은 응집도를 생각해서 SOILD 원칙에 기반하여 작성한다면..
요새 챗 AI 를 시켜서 일 을 할 때 최고의 효율성으로 일하고 빠른 유지보수 및 기능 개발이 가능하다고 생각한다.
구조가 있다면 AI 는 더 쉽게 접근하여 파일 단위로 파악을 진행하여 더 정확한 답변을 주는 부분을 알게됐다.
어쨋건 해당 부분처럼 따로 분리하여 작업을 진행 하면서 다른 팀원과 타부서 몇백명 이상과.. 협업을 진행 하다보니
Saas 설치형으로 나아가다 보면 본질을 자꾸 흐리게 되고 빠르게만 코드의 퀄리티를 떨어트리는 부분이 분명이 크다는 점을 느꼈다.
SI 업체 출신 개발자들을 싫어하는건 아니지만.. 너무 체계가 없고 무조건 빠르게빠르게를 외치시니 작업 하는 부분이 꽤 많이 힘들었다..
오늘도 다시 되 돌아 보게된다. 잘 하는 개발자는 빠른속도만 있는게 아니라 체계적이고 레거시 코드가 되어도 구조와 왜 이렇게 구현을 했는지 파악이 가능한 개발자라는걸 AI 발전속도에 우리의 직업이 위협을 받는게 아니라 생존해나가면서 전체 플로우를 판단하고 구조적인 부분을 체계적으로 이끌어나가고 기획적인 부분과 더불어 사용자 편의성을 고려하는 프론트엔드 개발자는 살아 남을 수 있을거라고 판단을 한다.
아래는 .. 기존 레거시 코드(규칙없이 믹스인으로 만들어둔 코드) -> send 의 너무 높은 결합도를 지니고 있어서 어디서 사용 하는지 모르는부분도 있었고 응집도는 낮아서 어디서 버그가 나는지 알 수 없는 형태였다. 아래의 형태를 차근차근 리팩토링 하는 과정을 작성 해보겠다.
처음 Plex 프로젝트는 Vue2 + Options API로 시작했음. 문제는 팀 구성이었는데, 대부분이 SI 업체에서 오신 분들..!!이라 프론트엔드 폴더 아키텍처나 코드 구조에 대한 개념 자체가 거의 없었음. 그래서 코드가 그냥 되는 대로 짜여 있었고, 점점 이런 문제들이 터짐 정말 힘든 싸움이었음.. 멱살잡고 끌고가는 수 밖에 없다는 판단이 섰음.. :
API 호출, 상태 관리, 유틸 함수가 여기저기 흩어져서 중복
어디에 무슨 로직 넣어야 하는지 기준 없음 → 사람마다 다 다르게 짬
새로운 기능 붙일 때 사이드 이펙트 대폭발
코드리뷰마다 “이건 어디다 넣는 게 맞냐” 싸움 반복
한마디로 아키텍처 자체가 없으니 팀워크도 안 돌아가는 상황이었음.
2. 그래서 내가 뭘 했냐?
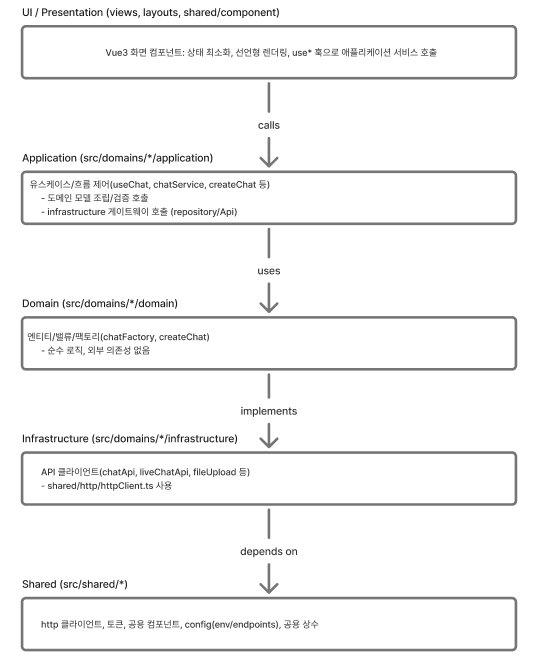
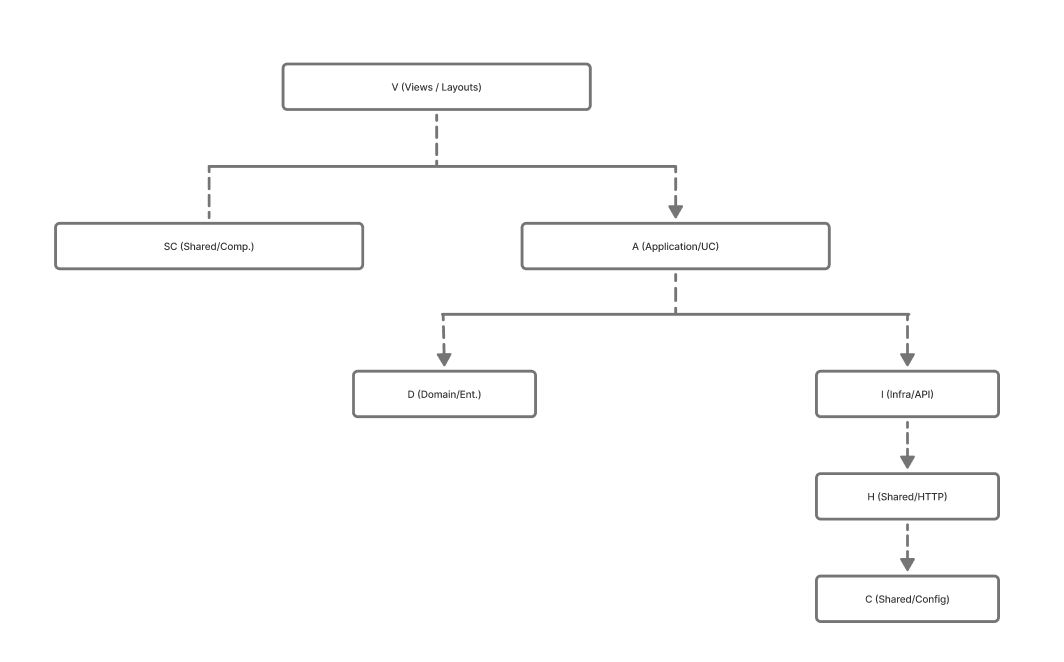
이대로는 답이 없겠다 싶어서 내가 Vue3 Composition API + DDD 구조를 제안하고 직접 셋업했음.
Vue3로 갈아탄 이유
로직 분리가 깔끔해지고 composable로 공통화하기 쉬움
신규 투입되는 사람도 구조만 보면 이해 가능
Options API보다 유지보수성이 훨씬 나음
DDD 아키텍처 적용
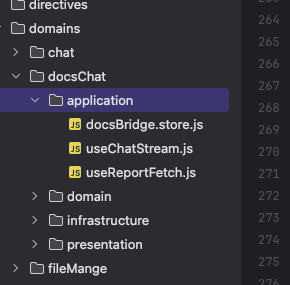
폴더 구조를 내가 직접 src/domains/{도메인}/application | domain | infrastructure로 재정리함.
구조가 분리되어 Jest + Vue Test Utils 도입이 쉬움(레이어별 독립 테스트 가능)
3. 바꾸고 나서
팀원 간 정리: “이건 infra로 내려야지”라는 기준 생김 → 더이상 애매하게 끼워넣기 안 함
가독성 상승: 신규 합류한 사람도 구조만 보면 금방 이해 가능
확장성 확보: Chat 도메인에 SSE 붙일 때 infra에 네트워크 코드만 추가하면 끝 → 손쉽게 기능 확장
중복 코드 제거: httpClient, 포맷터 같은 거 infra/application에서 불러다 쓰니 코드 정리됨
4. 결론
Vue3 + DDD 도입은 단순히 최신 기술 써본 게 아니라, 아키텍처 개념이 없던 팀에 기준을 세운 일이었음. 아무도 모르는 상태에서 내가 직접 끌고 와서 구조를 잡아주니까, 코드만 깔끔해진 게 아니라 팀 내 갈등도 줄고 협업 효율도 올라감. 결국 Plex 프로젝트는 그 덕분에 안정성 + 확장성 + 팀워크까지 챙길 수 있었음.
오늘은 프론트엔드에서도 DDD를 왜 적용해야하는지에 대해서 기록을 하고 정리를 하는 글을 작성할 것이다.
프론트엔드에서 DDD를 적용한다고 하면, 흔히 백엔드 개념 아닌가?라는 반응이 나오곤 한다. 하지만 프론트엔드도 점점 복잡한 도메인을 다루게 되면서, 백엔드처럼 체계적으로 도메인 중심 설계를 적용하는 것이 중요해졌다.
프론트엔드에서 DDD를 적용해야 하는 이유
도메인 로직이 복잡해진다. → 단순한 UI만 처리하는 것이 아니라, 상태 관리, 도메인 규칙, 비즈니스 로직까지 포함되기 때문이다.
백엔드와의 협업이 중요하다. → 백엔드 DDD와 정합성을 맞추어야 하기 때문이다.
프론트엔드 규모가 커진다. → 컴포넌트와 상태 관리를 효율적으로 분리해야 하기 때문이다.
유지보수성이 증가한다. → 도메인 단위로 설계하면 변경에 강한 구조가 될 수 있기 때문이다.
프론트엔드에서 DDD 적용 핵심 개념
1. 도메인 모델링: Entity와 Value Object
프론트엔드에서도 도메인 모델을 정의해야 한다.
Entity: 식별자가 있는 객체를 의미한다. (예: User, Order, Product)
Value Object: 변경 불가능하고 식별자가 없는 객체를 의미한다. (예: Money, Address, DateRange)
적용 예시
// Value Object: 가격을 다룰 때
class Money {
  constructor(private readonly amount: number, private readonly currency: string) {}

  add(other: Money): Money {
    if (this.currency !== other.currency) {
      throw new Error("Different currencies cannot be added.");
    }
    return new Money(this.amount + other.amount, this.currency);
  }
}

// Entity: 제품 정보
class Product {
  constructor(public readonly id: string, public name: string, public price: Money) {}
}

const apple = new Product("1", "Apple", new Money(1000, "KRW"));
이렇게 하면?
가격 계산 로직이 여기저기 흩어지지 않고 Money 안에 집중될 수 있다.
Product의 가격을 직접 수정하는 대신 Money 객체를 활용하여 유지보수성이 높아진다.
2. 애그리게이트(Aggregate) 패턴 적용
애그리게이트는 도메인의 일관성을 유지하는 그룹을 의미한다.
핵심 개념은 **하나의 애그리게이트 루트(Aggregate Root)**를 통해서만 내부 데이터를 변경할 수 있다는 점이다.
예를 들어, Order가 OrderItem을 포함하지만, OrderItem을 직접 수정할 수 없다.
적용 예시
class OrderItem {
  constructor(public readonly id: string, public readonly product: Product, public readonly quantity: number) {}
}

class Order {
  private items: OrderItem[] = [];

  constructor(public readonly id: string, public readonly userId: string) {}

  addItem(product: Product, quantity: number) {
    this.items.push(new OrderItem(`${product.id}-${quantity}`, product, quantity));
  }

  getTotalPrice(): Money {
    return this.items.reduce((total, item) => total.add(item.product.price), new Money(0, "KRW"));
  }
}

const order = new Order("order-123", "user-456");
order.addItem(apple, 2);
console.log(order.getTotalPrice()); // Money { amount: 2000, currency: 'KRW' }